mokujiro.com の日本語版
ひとつのサイト、ふたつの言語、そしてネイティブとして読める翻訳の工程
項目 | 内容 |
|---|---|
プロジェクト種別 | スタジオプロジェクト:mokujiro.com 日本語版 |
公開状況 | mokujiro.com/ja で公開中 |
実装環境 | Framer Localization、Framer CMS、 |
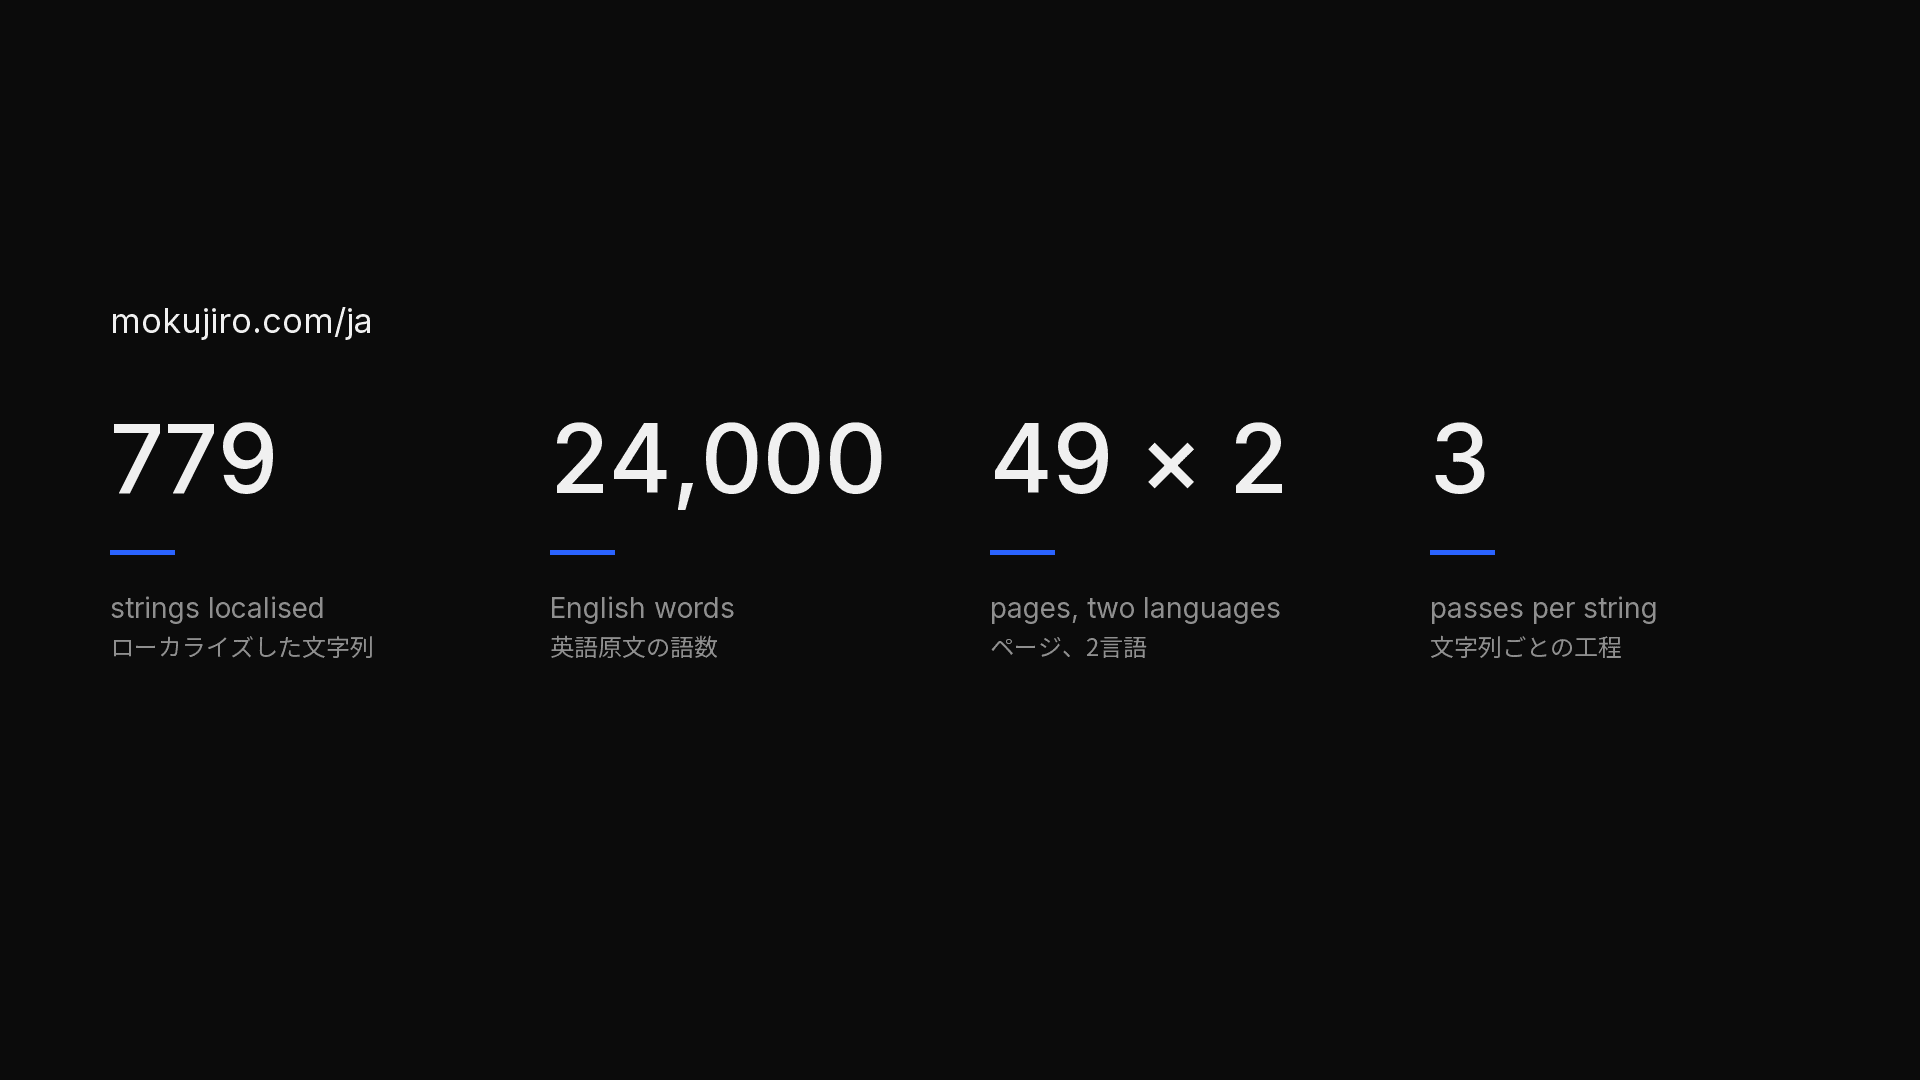
制作規模 | 49ページ、2言語、ローカライズした文字列779件、英語原文約24,000語 |
スタジオ | Mokujiro Studio |
デザイナー | 田井憲橘 |
背景と目的
Mokujiroは、日本とオーストラリアの両方で仕事をしています。一方で、ウェブサイトは英語のみで提供していたため、日本の読者は第二言語で情報を読む必要がありました。
本プロジェクトでは、日本語版の要件を三つに定めました。日本語で書かれた文章として自然に読めること、英語版と同じウェブサイトの中で提供できること、そして別サイトを追加せずに運用できることです。英語を日本語へ置き換える作業にとどめず、この三つを満たす構成を設計することを目的としました。
システム構成
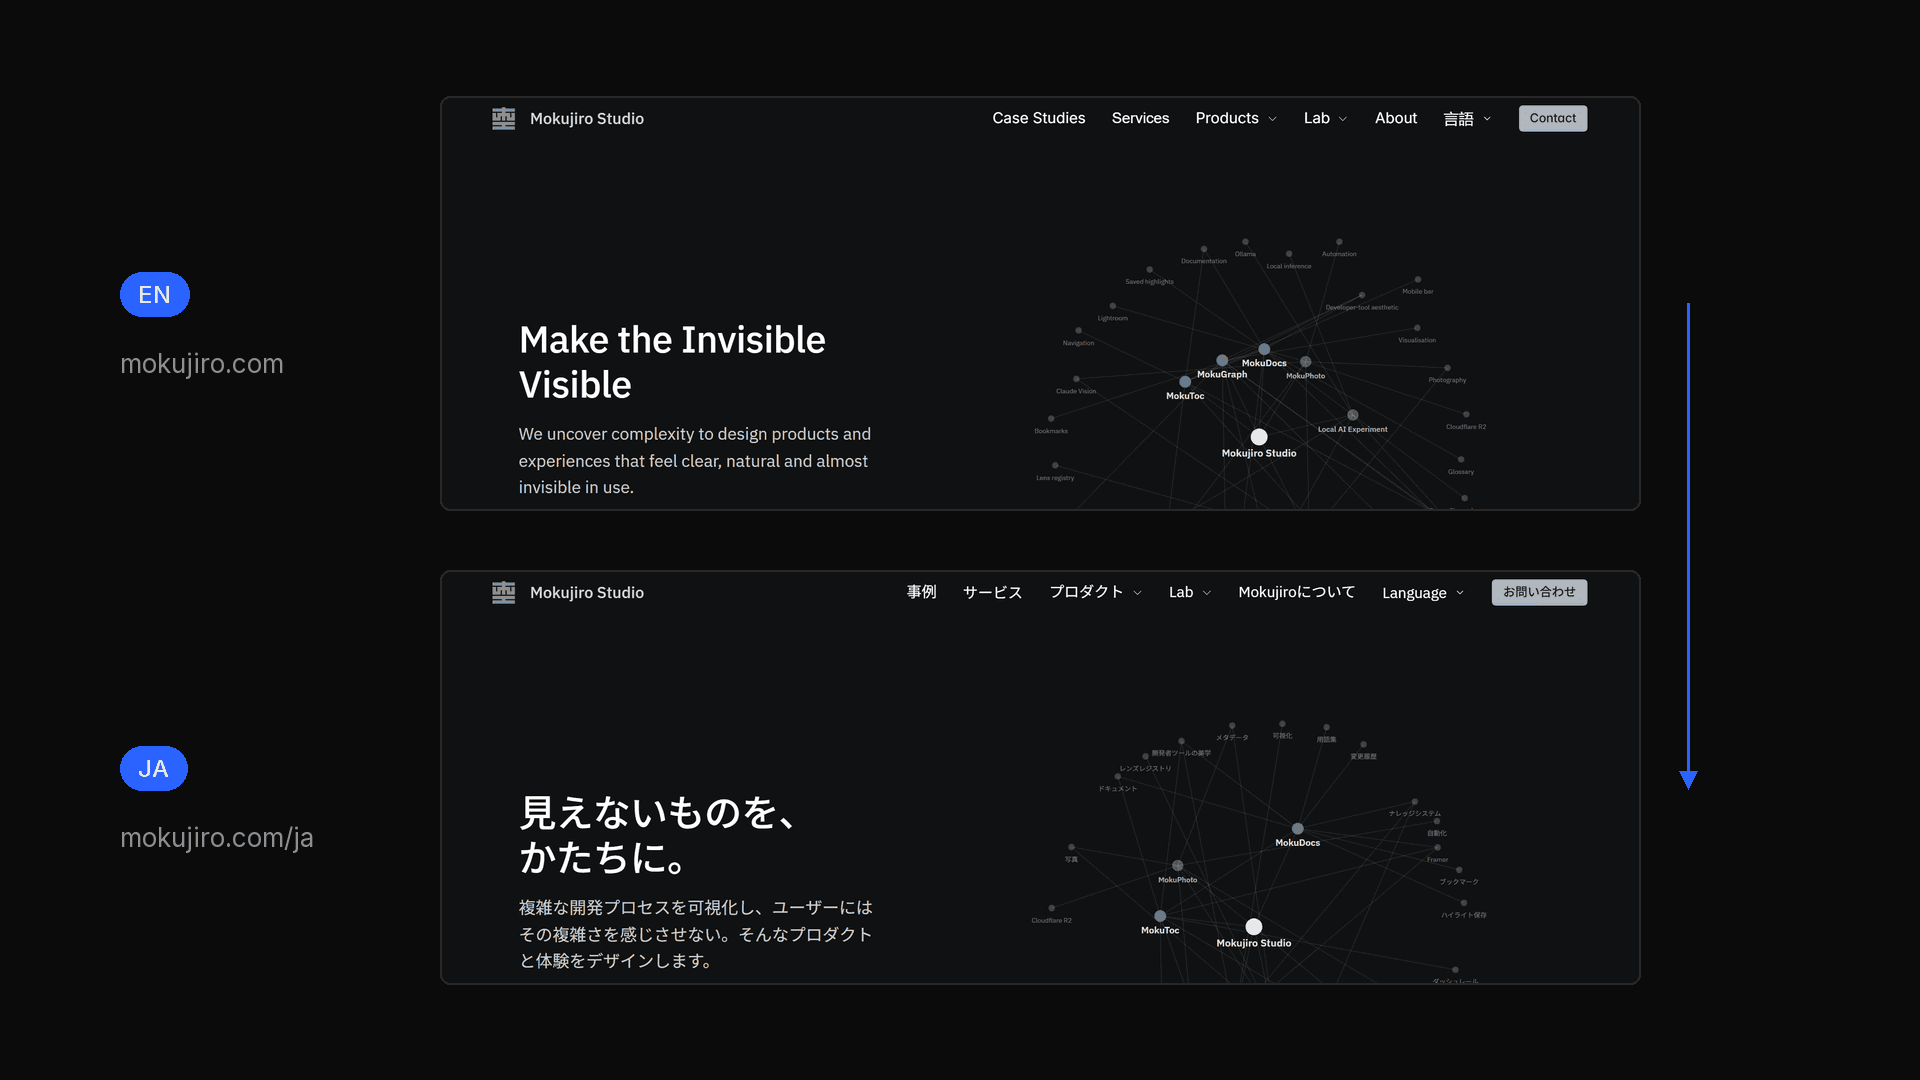
第二言語の管理には、Framer Localizationを使用しました。英語版はルートドメイン、日本語版は /ja 配下に配置しています。hreflang、canonical、言語別のサイトマップはFramerが生成するため、SEOに関わる設定を手作業で追加する必要はありませんでした。
事例、プロダクト、Lab、サービスは、Framer CMSのコレクションとして管理しています。各アイテムのテキストフィールドに日本語を追加し、スラッグ、画像、日付、価格といった言語に依存しない情報は、英語版と日本語版で共有しました。
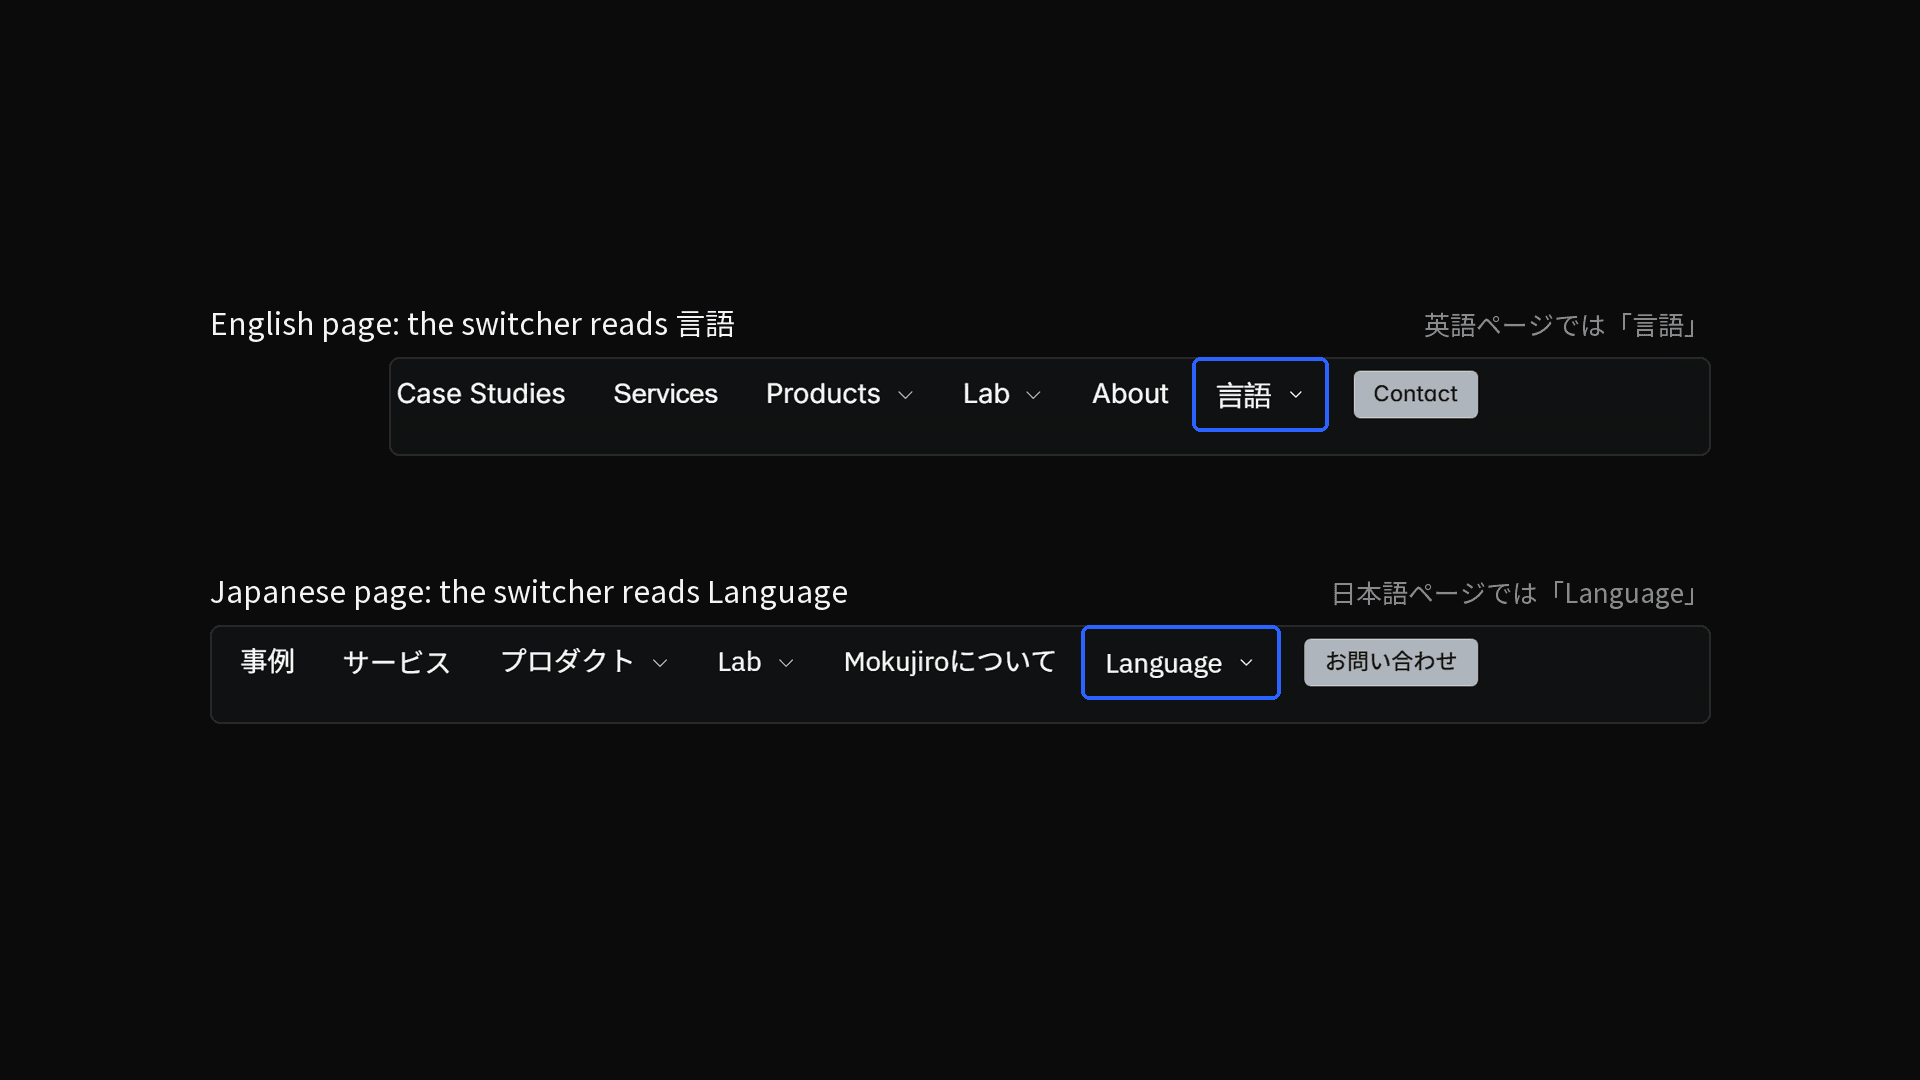
言語セレクター、更新バナー、ヒーローセクションのナレッジグラフ、アプローチセクションのタブは、コードコンポーネントとして実装しています。各コンポーネントは useLocaleInfo から現在のロケールを取得し、コード内に置いた英日辞書から対応する文言を選択します。コンポーネント内の内部リンクにも同じ処理を適用し、日本語ページではリンク先のパスに /ja を付加しています。
日本語フォントの適用
サイトの基本書体であるIBM Plex Sansには、日本語のグリフが収録されていません。そこで、カスタムコードでNoto Sans JPを読み込み、フォントスタック上でIBM Plex Sansの後に指定しました。この構成では、英数字にIBM Plex Sansが、かなと漢字にNoto Sans JPが適用されます。英語版の視覚的な印象を保ちながら、日本語に必要な文字を補う設計です。
もう一点、Framerは初回描画の後にHTMLの lang 属性を切り替えます。そのままでは初回描画の時点で日本語向けの指定が効かないため、描画前に lang 属性を設定するスクリプトを追加しました。
日本語ローカライゼーションの方法
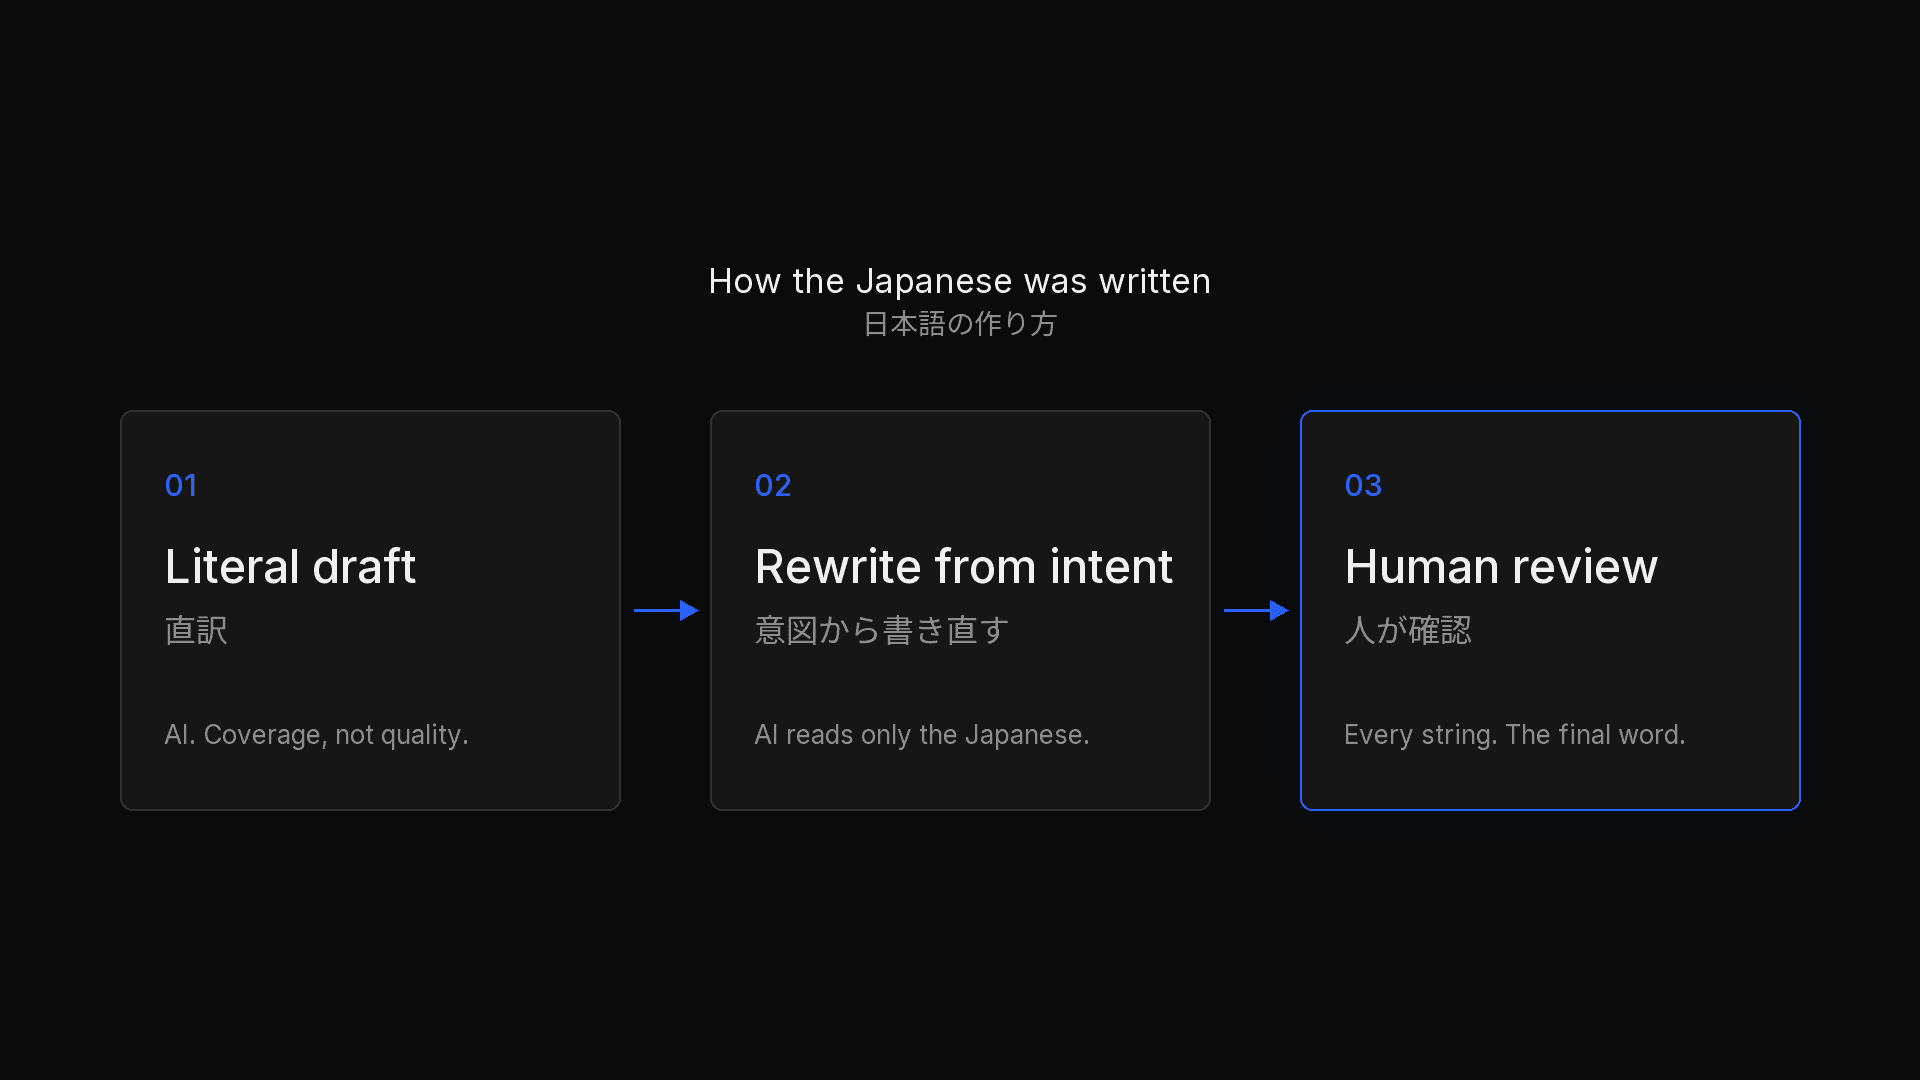
本プロジェクトでは、機械翻訳を、原文の情報を漏れなく移すための初稿として位置づけました。語彙が正しく訳されていても、英語の構文や論理展開が残ると、日本語として不自然な文章になります。この問題を軽減するため、翻訳と編集を三つの工程に分けました。
初期翻訳 AIが英語原文を日本語へ翻訳します。この段階では、表現の完成度よりも情報の欠落がないことを優先しました。
日本語のみを参照した再編集 AIが日本語の文章だけを読み、各文の意図を捉え直したうえで、同じ内容を自然な日本語として再構成します。この工程では、英語原文を参照対象から外しました。
人による全文レビュー 最後に、私が779件の文字列を確認し、語調、文脈、ブランドとしての一貫性を調整しました。タグラインとスタジオの説明文については翻訳を使わず、日本語として新たに書いています。
この工程を通じて、ページの種類ごとの編集ルールも定義しました。
スタジオのページでは、一人称に「私」を使用する。
法務関連のページでは、「当スタジオ」を使用する。
日本語本文ではダッシュ記号を使用しない。
プロダクト名とサービス名は英語表記を維持する。
サービスページの見出しは、共通の構成に統一する。
これらのルールにより、ページの目的に応じて語調を変えながら、サイト全体の一貫性を維持しました。
779件の文字列を反映する仕組み
FramerのExternal Agentは、Localizationの翻訳データに直接書き込めません。一方、同じセッション内から実行するPlugin APIでは、翻訳データを更新できます。この違いを利用して、反映の工程を自動化しました。
翻訳の下書きは、英語原文をキーとする辞書として管理しています。スクリプトが辞書とFramer上の原文を照合し、対応する779件の日本語を一回のAPI呼び出しで反映します。レビュー後に表現を変更した場合も、辞書を更新してスクリプトを再実行するだけで反映できます。Framer上の文字列を一つずつ手作業で修正する必要がなくなり、翻訳データの一貫性と更新のしやすさを保てました。
編集の判断を蓄積する仕組み
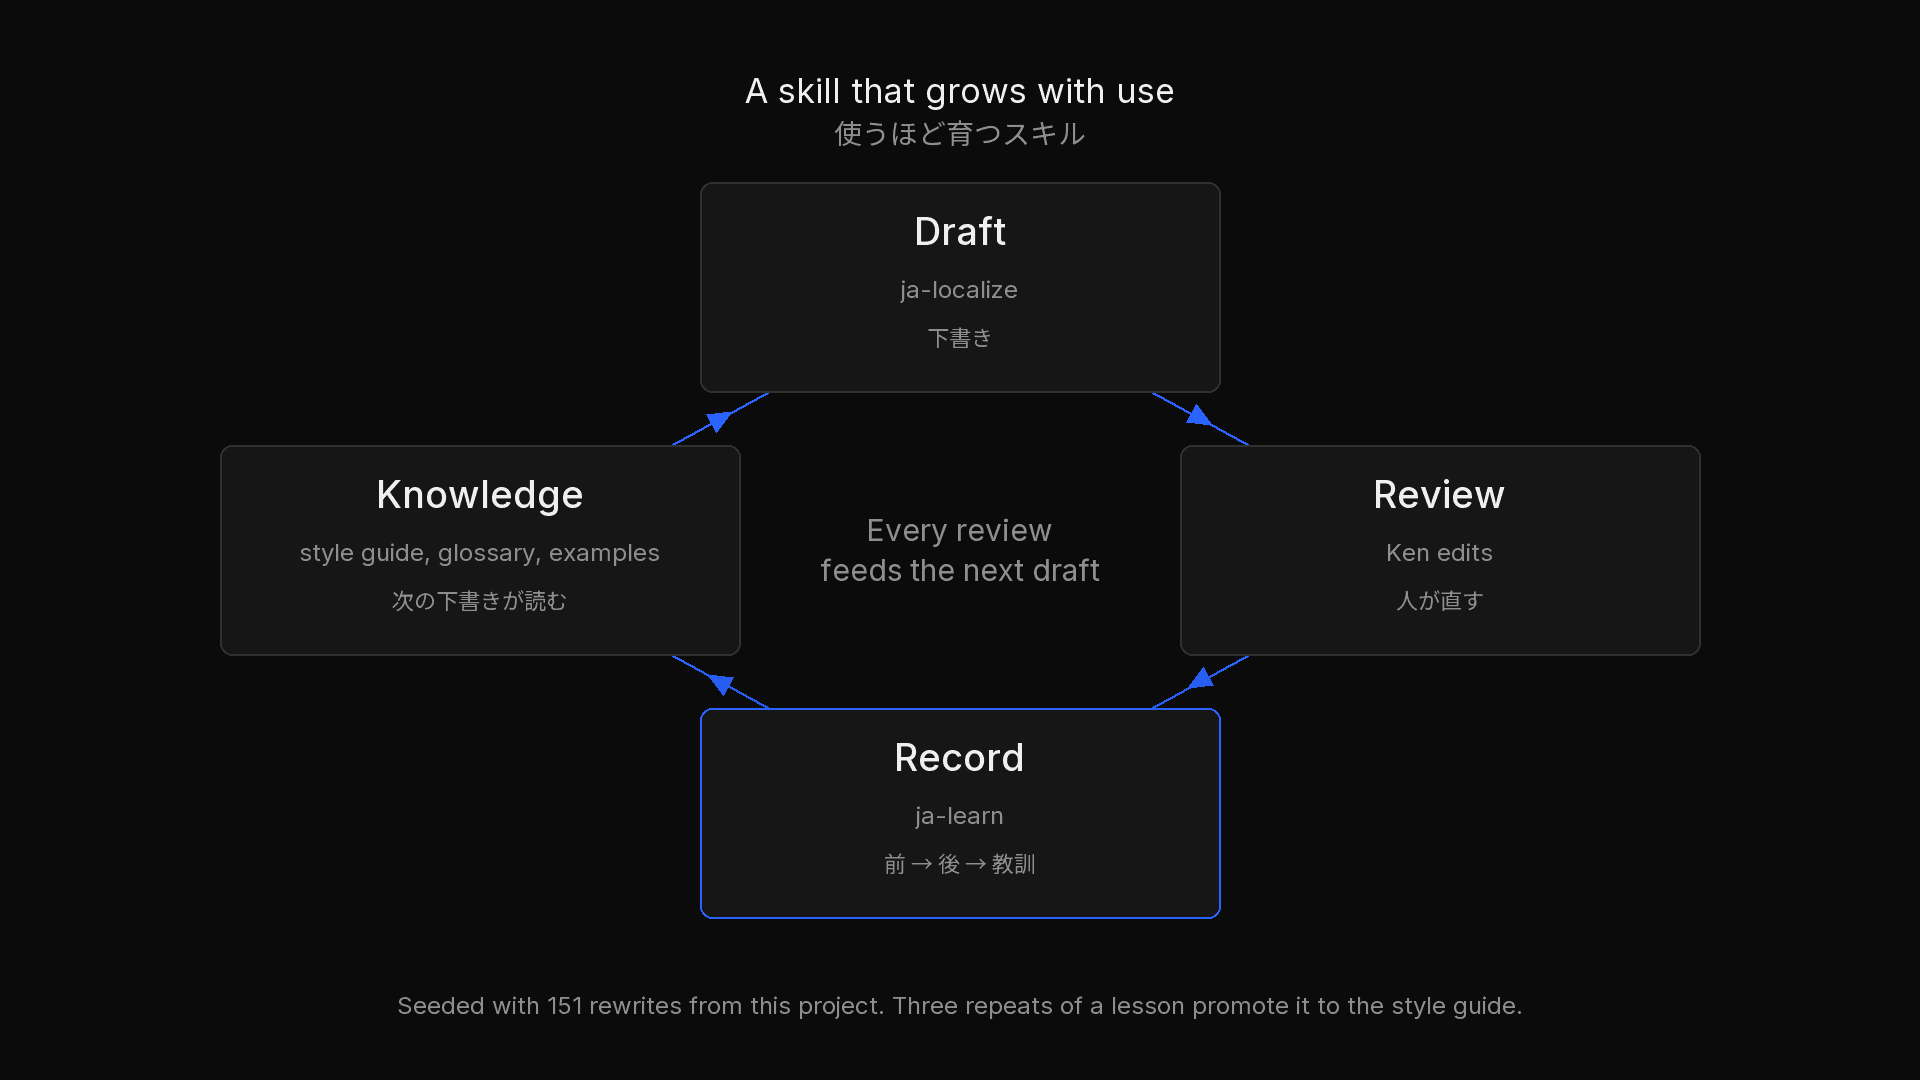
人によるレビューで生じた修正を、次回以降の翻訳に活かすため、Claude Code上に二つのスキルを作成しました。
一つは、日本語を書くためのスキルです。スタイルガイド、用語の対訳表、承認済みの文例、修正の記録という四つの知識ファイルを読んでから、前述の三工程で日本語を作成し、英日対照の表としてレビューに出します。
もう一つは、レビューの結果を記録するためのスキルです。案と最終稿の差分を「前、後、教訓」の形式で記録し、対訳の決定は用語表へ、そのまま採用された文は文例へ反映します。同じ教訓が三回現れた場合には、スタイルガイドへの追加を提案します。修正の記録には、本プロジェクトの再編集で生じた151組の書き換え例を初期データとして収めました。
レビューでの修正を毎回この仕組みに戻すことで、翻訳の判断を文書として蓄積し、繰り返し使える形にすることを意図しています。
公開前の検証
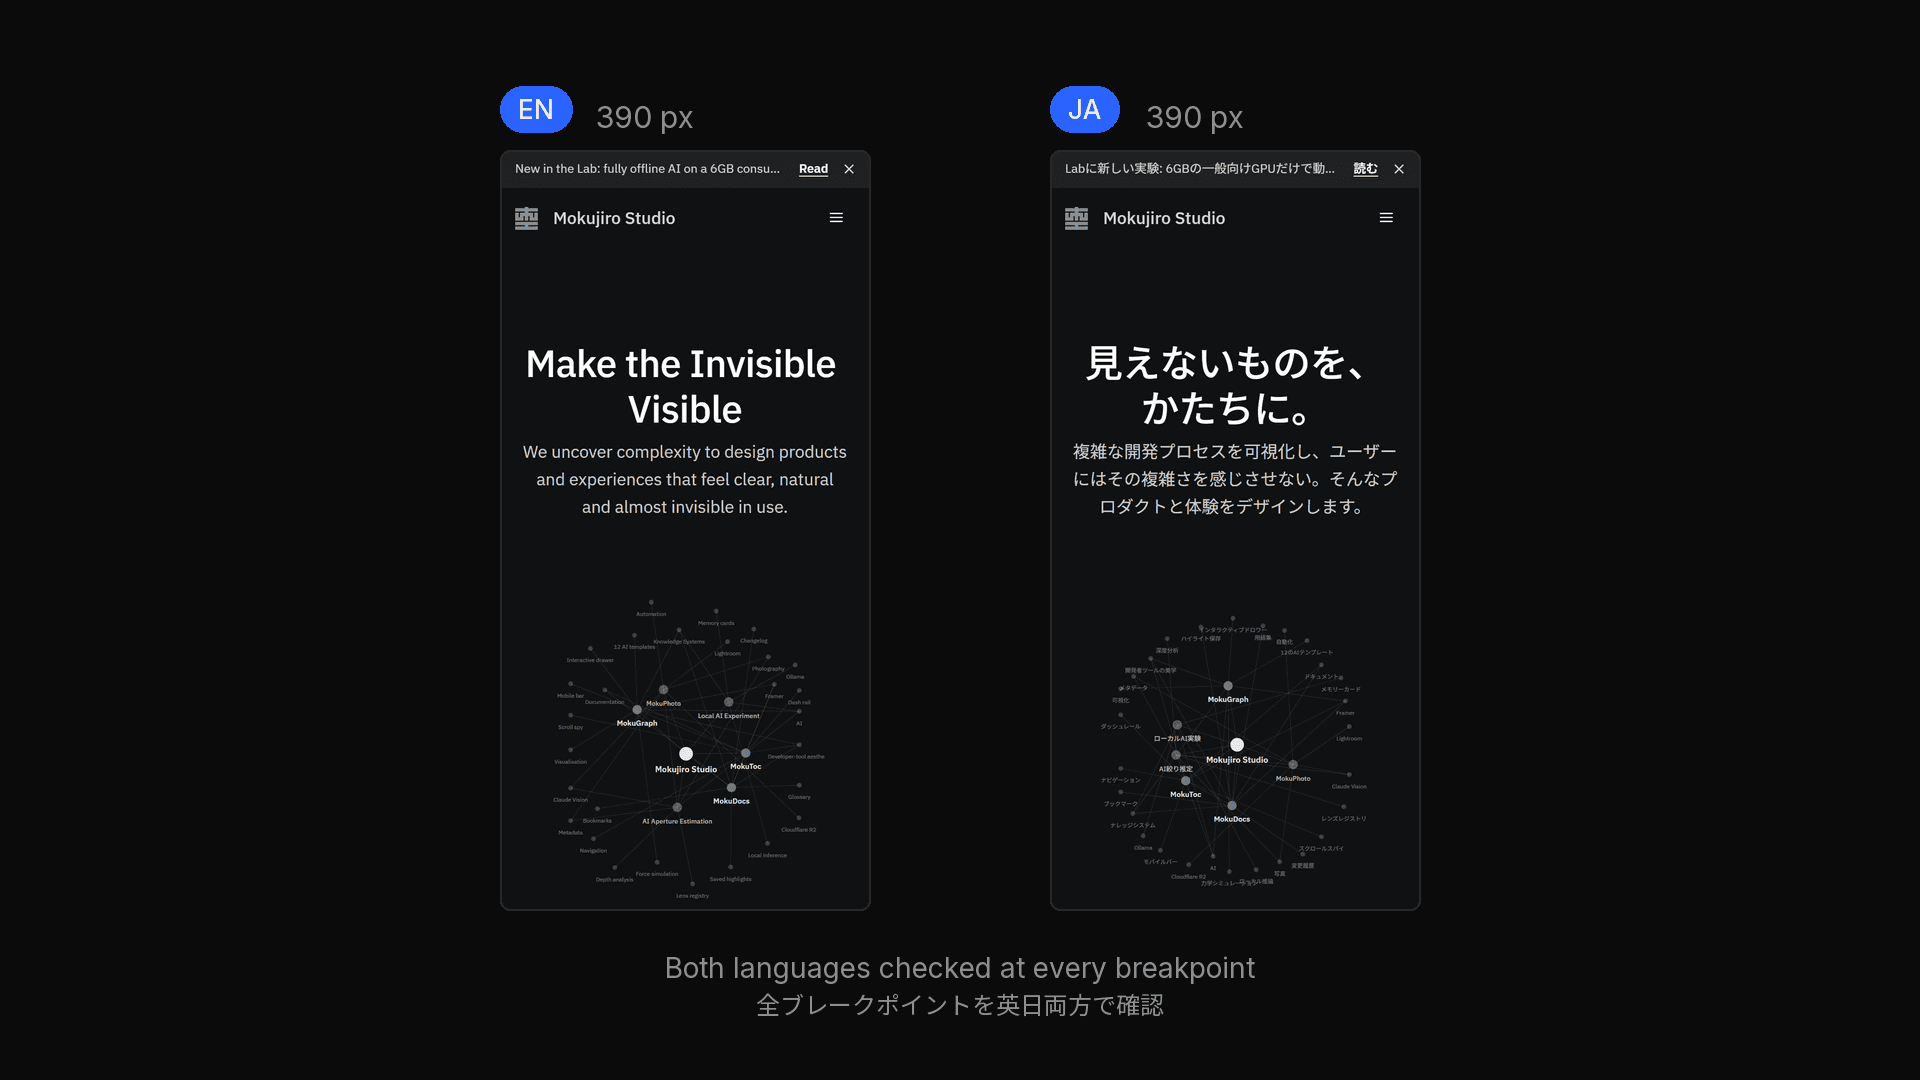
ローカライゼーションでは、文章の正確さに加えて、リンク、SEO情報、レスポンシブレイアウトの検証が必要です。日本語への変更で文字幅や改行位置が変わり、英語版では生じなかったレイアウト上の問題が起こりうるためです。
公開前には、全ページの英語版と日本語版を取得し、両者を比較するスクリプトを実行しました。主な検証項目は以下のとおりです。
未翻訳の文字列
日本語ページから英語ページへ戻る内部リンク
ブレークポイントごとのセクション順
metaタグ
canonical
hreflang
検証の結果、三つの問題が見つかりました。一つ目は、スマートフォン表示でフッターが画面幅を超えていたことです。二つ目は、タブレット表示でフッターが二つのセクションより前に配置されていたことです。三つ目は、フォームラベルの一部が英語のまま残っていたことです。いずれも、日本語版の公開前に修正しました。
得られた知見
本プロジェクトから得られた実装上の知見は、以下の四点です。
コードコンポーネントの多言語化は、プロパティパネルではなくコード側で管理する。配列型プロパティにローカライズ値が設定されると、コンポーネントがデフォルト値を参照する挙動が変わる場合があります。
CSSが
lang属性に依存する場合は、初回描画前に適切なlangを設定する必要がある。Framer CMSのenumは多言語化できない。言語によって表示を変える値は、文字列フィールドとして管理するか、コード側で処理する必要がある。
多言語化の後は、すべてのブレークポイントを検証する。言語が変わると文字列の幅や改行位置も変わるため、英語版の確認だけではレイアウトの品質を保証できない。
結論
翻訳と多言語サイトの構築は、別の作業です。自然な多言語体験には、文章だけでなく、CMSのデータ構造、コードコンポーネント、フォント、SEO、内部リンク、レスポンシブレイアウトを一つのシステムとして設計する必要があります。
本プロジェクトでは、AIによる初期翻訳、日本語のみを参照した再編集、人による全文レビューを組み合わせました。さらに、Plugin APIによる一括反映、英語版と日本語版を比較する自動検証、レビューの判断を蓄積するスキルを導入し、49ページにわたる日本語版を継続的に更新できる形で実装しました。