ローカルAI実験
一つの構成を棄却し、AIの応答品質を本当に左右するものを突き止めた
項目 | 内容 |
|---|---|
種類 | 実験:あえて控えめなハードウェアで動かす、完全オフラインのAI |
ステータス | 進行中 |
カテゴリー | ローカルAI、ベンチマーク、メモリシステム |
技術構成 | Ollama、Gemma 3 4B、Qwen 3、依存パッケージのないNode.js製テストハーネス |
ハードウェア | 一般向けノートPCのGPU(RTX 3060、VRAM 6GB) |
スタジオ | Mokujiro Studio |
デザイナー/AIエンジニア | 田井憲橘 |
期間 | 2026年8月から継続中 |
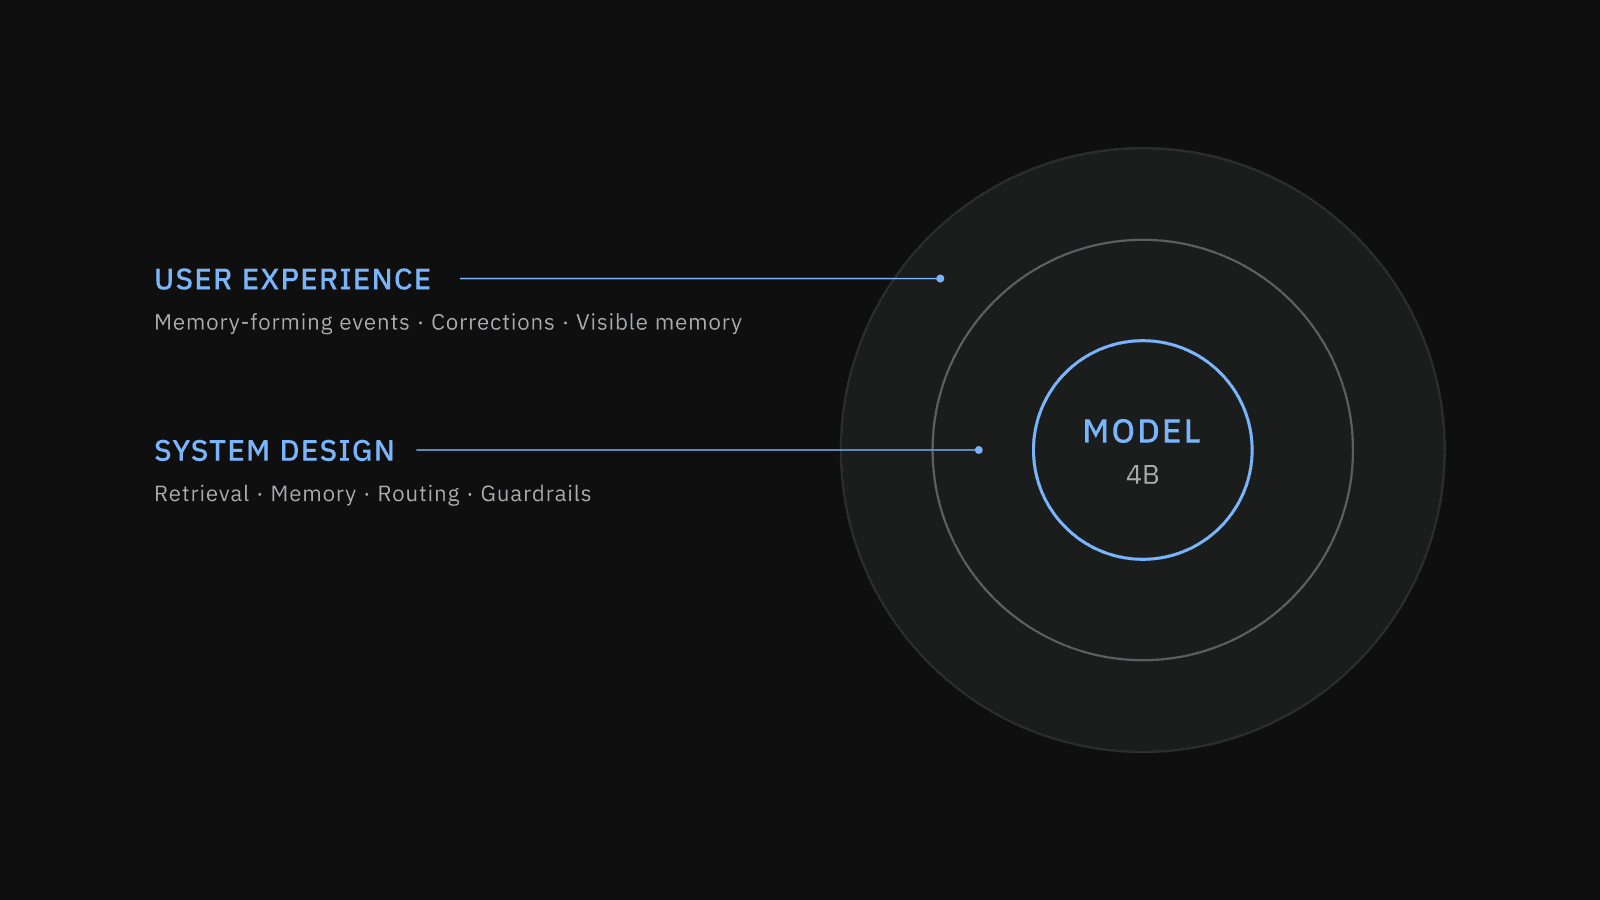
AIの賢さの多くは、モデルではなく、その周囲のシステムが担っている。
背景と目的
一般的なノートPCだけで動く完全にローカルなAIは、使い続けるうちに「私の仕事の進め方を理解している」と感じられるものになるのか。本実験の目的は、この点を検証することです。
方法は、モデルの学習ではありません。モデルは一切変更せず、代わりに「蓄積」に賭けます。使用のたびにシステムが私の判断と修正を記録し、必要なものを必要な場面で取り出して、モデルが回答する前に文脈として渡します。この循環が機能すれば、実際に使い始めてから4週間ほどで、回答が自分向けのものとして感じられるようになるはずです。
前提として、一つのルールを設けました。データは一切、このマシンの外に出しません。外部APIも、クラウドでの推論も使用しません。クライアントの未公開キャンペーンを預かる写真家や、NDAのもとで働くスタジオにとって、この制約は好みの問題ではなく、絶対条件です。
実験としての設計
ノートPCでモデルを動かすだけであれば、それはデモです。本実験では、仮説、固定した測定方法、そして開始前に決めた失敗条件の三つを定めました。取り出した情報が自分でファイルを探すより遅いと感じた場合、修正を重ねても回答が変わらない場合、あるいは単に使わなくなった場合には、仮説を棄却します。正直に公開した失敗は成功と同じ価値を持つと考えており、どちらの結果もこのページで公開します。
ハードウェアの下限
検証環境
検証機は、あえて控えめな構成にしています。一般向けノートPCのGPUであるRTX 3060(VRAM 6GB)に、ランタイムとしてOllamaを使用しました。この環境で快適に動作すれば、必要なハードウェアは多くの現役クリエイターの手の届く範囲に収まります。五つのオープンモデルを導入し、同一条件で計測しました。
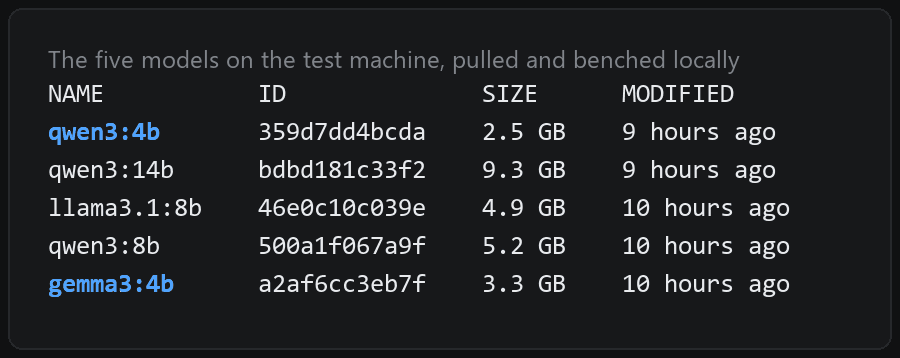
速度と発熱
モデル | 持続 tok/s(高温時) | コールドスタート tok/s |
|---|---|---|
Gemma 3 4B | 12.6 | 55.5 |
Qwen 3 4B | 12.3 | 14.3 |
Qwen 3 8B | 6.6 | 7.7 |
Llama 3.1 8B | 7.7 | 8.6 |
Qwen 3 14B | 3.5 | 4.1 |
重要なのは、二つの列の差です。この種のノートPCは、発熱によって短時間で大きく速度が低下します。GPUはアイドル時63°Cで、プロンプト2回ほどで88から96°Cに達し、連続して実行すると毎秒46.9トークンから15.1トークンまで低下しました。コールドスタートの数値は、どのモデルも実力以上に見えます。実際の使用で付き合うことになるのは、持続時の数値です。
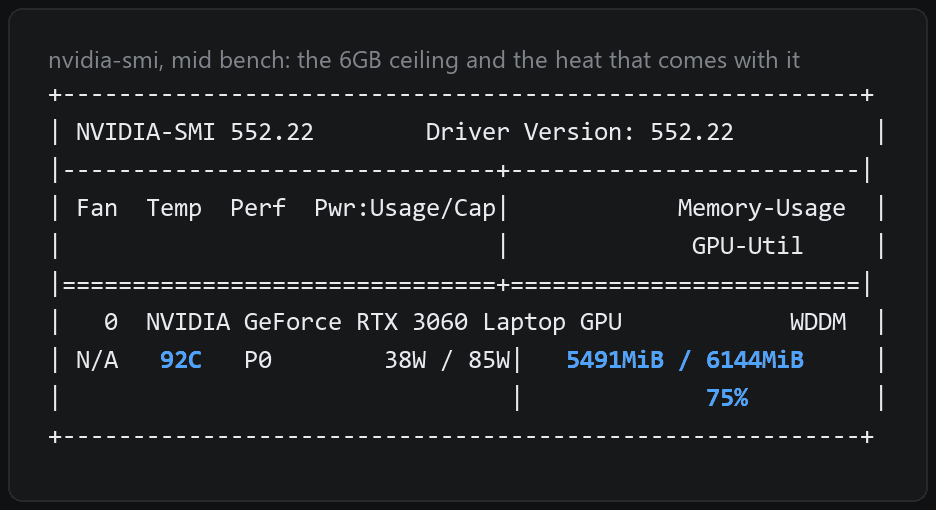
上の画面は、この制約を一枚で示しています。GPU温度は92°C、VRAMは6144MiBのうち5491MiBを使用中です。8Bクラスは温度にかかわらず毎秒7から9トークンにとどまりました。これは人が読む速さであって、作業に使える速さではありません。この結果から、8Bクラスはこのハードウェアでは対象外としました。14Bはさらに遅く、VRAM 6GBで現実的に使えるのは4Bクラスと判断しました。
GemmaとQwenの比較
実質的な比較対象は、二つの4Bモデルでした。持続速度ではGemma 3 4Bが上回り、回答を並べて読み比べると、日本語の文章も五つのモデルの中で最も自然でした。この構成での弱点は一つ、標準のGemma 3 4Bは検索ツールを直接扱えないことです。ただし、次に述べる検証結果によって、この弱点は問題ではなくなりました。
検証結果
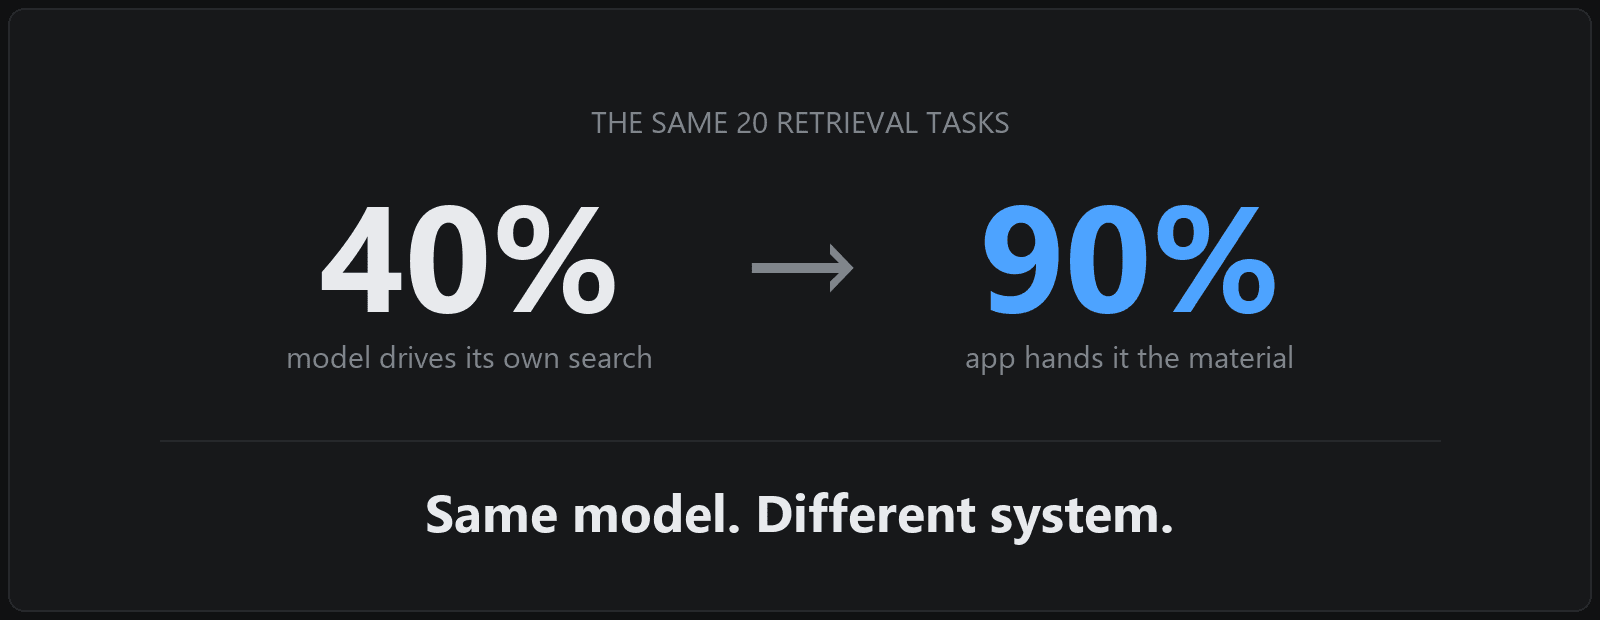
同一モデル、二つの条件
同じ20件の検索タスク(日本語14件、英語6件)を、7ファイルからなる同一のプロジェクト資料に対して、二つの条件で実行しました。合否は自動で判定しています。
Qwen 3 4Bがツールを使って自力で検索した場合の成功率は40%でした。同じ資料をモデルに直接渡した場合は90%です。
同じモデルです。
そしてGemmaは、この構成ではツールを一切使えないにもかかわらず、資料を渡せば同じ90%に達しました。
採点の内訳は次のとおりです。自動採点の素点は、Qwenが20件中16件、Gemmaが20件中17件でした。20件の判定のうち2件は、ツールを呼び出さなければ通らない項目です。ツールなしの条件では定義上達成できないため、条件間の比較対象から外しています。対象となる18件で採点すると、両モデルとも90%に達します。除外した項目は、ベンチマークの報告書に明記しています。
ツールを使う方式は、プロンプトの工夫だけでは改善しませんでした。検索を優先させるプロンプトはむしろ逆効果で、モデルは上限回数まで検索を繰り返しました。ツール対応の四つのモデルを4Bから14Bまで同じ方法で計測しましたが、事前に設定した基準に近づくものはありませんでした。このタスクセットとツール構成では、モデル主導の検索は実用に足る信頼性を持たないと結論づけました。
バイリンガルのユーザーとして、もう一つ重要な結果がありました。検証したケースでは、言語をまたいだ検索も機能しました。日本語で尋ねた質問に対して、英語で書かれた資料から回答を取り出せています。
構成の判断
このベンチマークによって、一つの構成を棄却しました。ベンチマークとは、そのためにあるものです。この構成では、モデルに検索を任せると信頼性が足りず、プロンプトだけでは改善しませんでした。そのため、検索はアプリケーション側が担当します。メモリ、ルーティング、ガードレールも同様です。モデルには、本当に得意なことだけを任せます。渡された文脈をもとに、ユーザーの言語で推論することです。
メモリの実体は、マシン上の通常のファイルです。モデルは何も保持せず、必要なときに参照するだけです。
メモリ
学習の仕組み
学習は、すべてモデルの外で行われます。私が何かを修正すると、その修正は候補のカードになり、私が承認するまで何も書き込まれません。承認したカードは、読む、編集する、削除するができる通常のファイルで、次の回答はそれを参照します。
下に示すのは、この循環が初めて一周した場面です。以前のセッションで一度伝えた好みが回答の根拠として返ってきており、memoryコマンドがどのカードを使用したかを示しています。
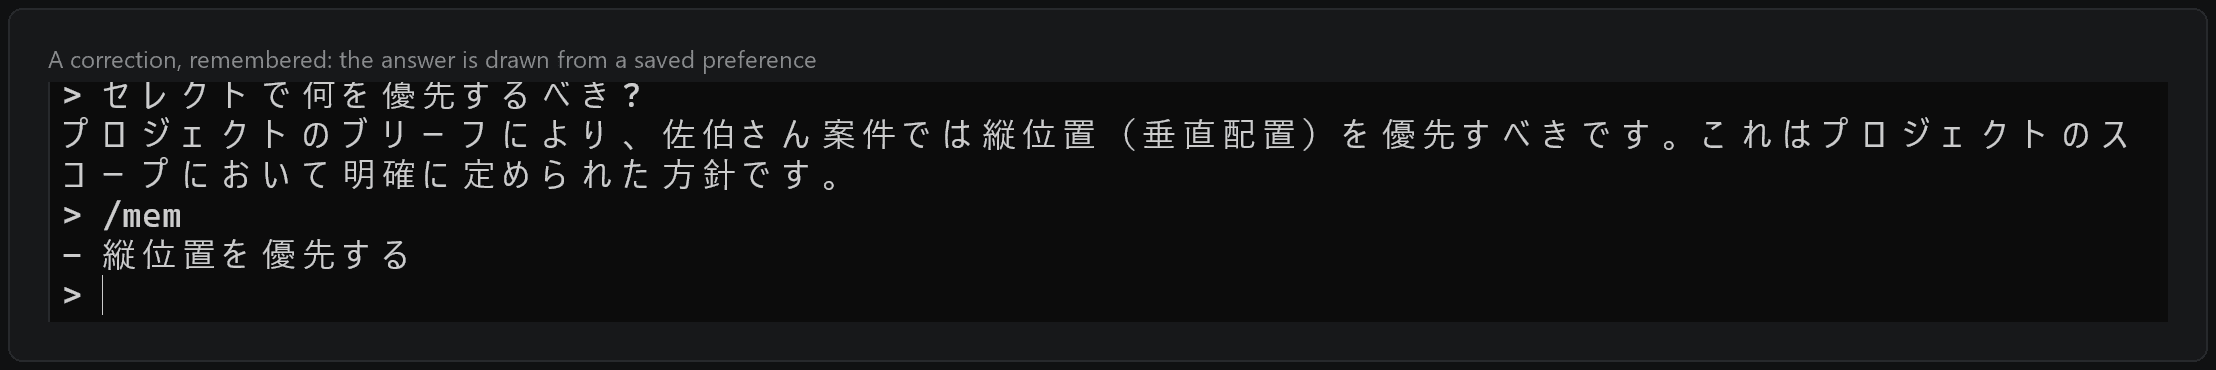
このやりとりは、実際のクライアントではなく、練習用のプロジェクトで行っています。練習用を用意しているのはこのためで、重要な資料に触れる前に、架空の仕事で循環を検証できます。
日常での運用
アプリケーション
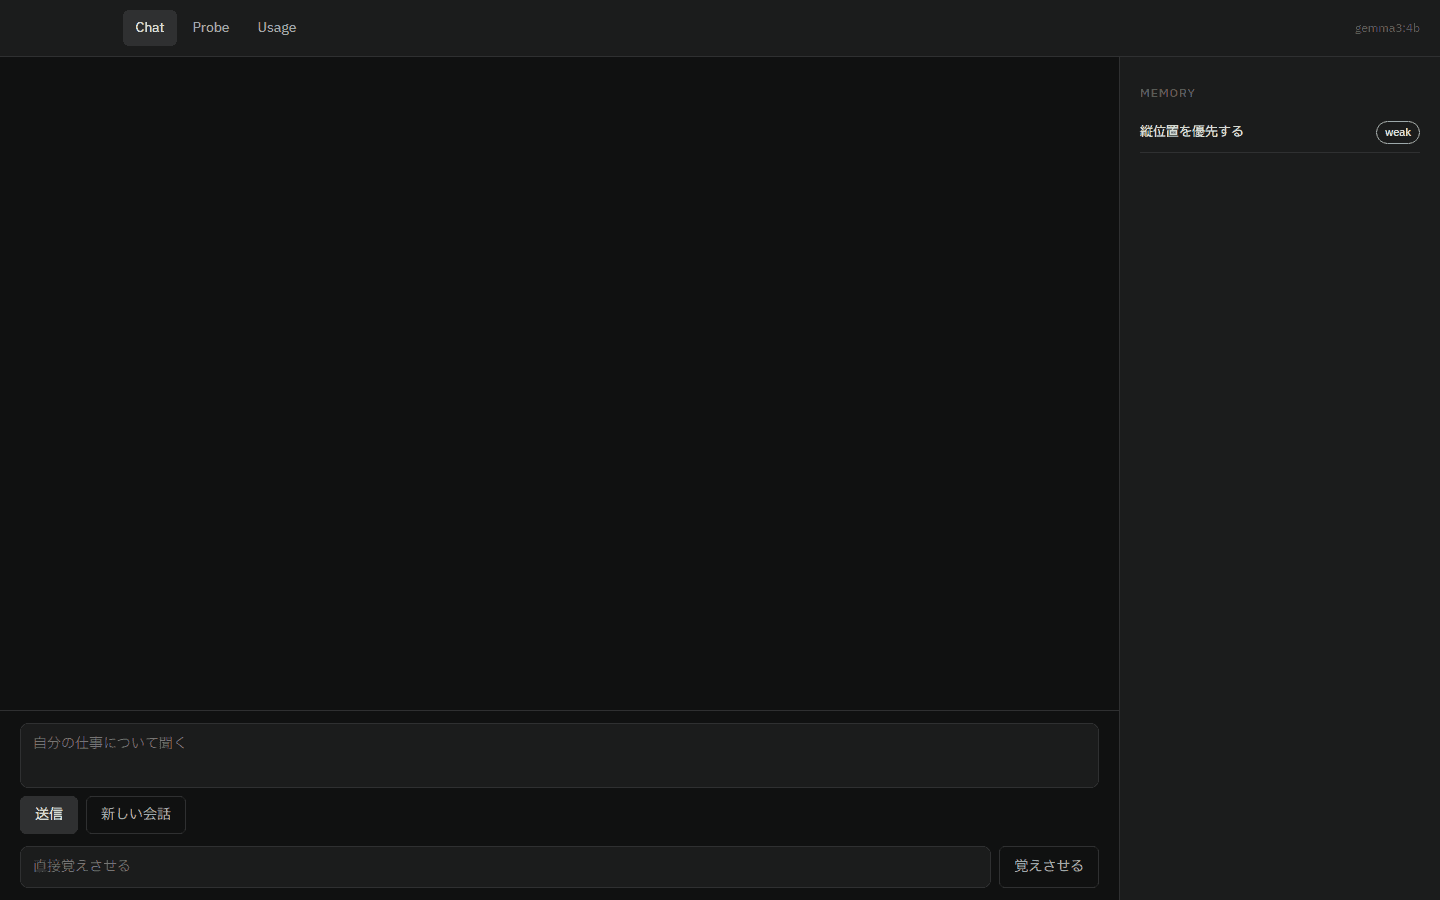
コマンドラインで循環は検証できました。日常的に使うには、画面が必要です。現在、本実験は同じマシン上の小さなローカルアプリケーションとして動いています。チャット画面、学習した内容がすべて見えて編集できるメモリのペイン、そしてプロトタイプから引き継いだ承認の仕組みで構成しています。
評価に使う質問
この段階では、人工的なテストセットは使いません。評価の基準は実際の使用です。質問は、日常的に使っている質問集から出し、それぞれが何を検証するかでタグ付けしています。
タグ | 検証する内容 |
|---|---|
ステータス | モデルが推測せず、構造だけで回答できるか |
検索 | 何か月も前に記録した判断を、プロダクト、撮影、事業をまたいで取り出せるか |
下書き | 説明ではなく、実際の文章を出力できるか |
判断 | 役立つ回答を出すために、私の仕事の進め方の理解が必要か |
教える | 一度伝えた好みが保持されるか |
ステータス
私の残ってるタスクは?
今日は2時間しかない。何をすべき?
検索
MokuDocs 2.0の価格いくらにしたんだっけ?
香川のシュートで何かトラブルなかったっけ?
今年の収益目標いくら?
下書き
納期を1週間延ばしてほしいと伝えるメールを下書きして
Instagramのキャプション案を1つ、私のスタイルで
判断
セレクトで縦と横で迷ってる。どっちにすべき?
LinkedInの次の投稿ネタどうする?
教える
金曜は撮影優先の日
迷ったら出荷を優先する
質問集には、この五つのカテゴリーで40件ほどのプロンプトがあります。ステータスと検索は、もはや本実験の主な未知数ではありません。ベンチマークによって、実用的な方法が確立したためです。評価を決めるのは残りの三つのタグです。下書きの依頼には、実際の文章が返ってくること。判断の相談には、私の仕事の進め方を踏まえた回答が返ってくること。一度伝えた好みが、次回以降も保持されること。この三つが条件です。
現時点の結論
ユーザーが「賢さ」として体験するものの多くは、モデルそのものではなく、その周囲に設計したシステムから生まれます。これが現時点での結論です。この仕組みは、私が開発中のデスクトップアプリケーションに組み込む予定です。日々の仕事から知識が蓄積し、すべてがマシンの中にとどまる構成を目指しています。
最終的な判断を下すまで、本実験はあと数週間続けます。どちらの結果も成果として、このページで公開します。